Seedream 5.5
100 回編集してもぶれない、最大 100 レイヤーに分解
Kling 4.0
キーフレームで構成を制御、参照でキャラクターを維持、最長 30 秒
GPT Image 2.5
精密な編集、参照に忠実、最大 4K
デジタルヒューマン動画
リアルなデジタルヒューマン動画をワンクリックで生成
画像から動画
複数モデルから選んで、プロ品質のAI動画を制作
動画字幕除去
動画の字幕とウォーターマークをスマートに除去
動作模倣
人物の動きとポーズを高精度に再現
フェイススワップ
自然な顔交換で、違和感のないリアルな仕上がり
Seedream 5.5
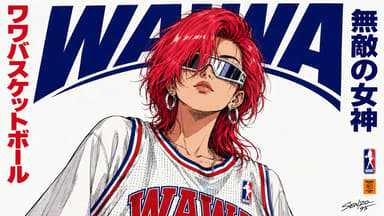
ByteDance Seedream の新世代画像生成・編集モデル。同じ画像を 100 回以上続けて編集しても被写体がぶれず、色も変わりません。リアルさが増し、小さな文字や多言語テキストの描画も大きく向上。1 枚の画像を最大 100 レイヤーに分けて編集できます。a2e でご利用いただけます。
Seedream 5.5 を見るKling 4.0
快手(Kuaishou)Kling の新世代動画生成モデル。最大 10 枚のキーフレームでカット割りを決め、最大 15 点の参照素材でキャラクターを安定させ、1 回の生成でネイティブ最長 30 秒、音声も映像と同時に生成。a2e でご利用いただけます。
Kling 4.0 を見るGPT Image 2.5
指示した部分だけを編集し、参照画像の製品や人物はそのまま保ちます。複雑なレイアウトにも対応。参照画像は最大 16 枚、1K〜4K と 13 種類のアスペクト比から選べます。
GPT Image 2.5 を見る
Seedance 2.5
ByteDanceの新世代プロフェッショナル・マルチモーダル動画モデル。長尺の物語性、強力なリファレンス、精密な編集、多言語 —— 4つの強化を一度に。a2e でご利用いただけます。
Seedance 2.5 を見る1枚の画像が動き出す
静止画を1枚アップロードするだけで、映画のようなカメラワークの動画を生成します。
無料のAIデジタルヒューマン動画・音声制作プラットフォーム
デジタルヒューマン動画、リップシンク、画像から動画、テキストから画像、音声クローン、顔交換などのAPIサービスに対応
最先端のリップシンクアルゴリズム
音声と口の動きをミリ秒単位で正確に合わせ、歯の噛み合わせ、口角の角度、息づかいまで再現します。
デジタルヒューマン動画
正確なリップシンク、自然でリアルな身体動作、顔と歯の高精細な表現を実現します。
テキストから画像
GPT Image、FLUX、Qwenなどのトップモデルを統合し、高品質なAI画像を高速生成します。